Pourquoi le score affiche-t-il 100 % pour deux fiches aux noms différents ?
Parce que les critères sont pondérés : le même numéro de TVA, le même téléphone et le même e-mail pèsent plus qu’un nom écrit différemment. L’écran d’examen montre chaque critère avec sa similarité, son poids et ses points, et la comparaison des champs marque ce qui est égal et ce qui diffère.
Dolibarr ne fusionne-t-il pas déjà les tiers ?
Si, depuis la fiche tiers. DataCleaner trouve les paires, les explique, prévisualise le résultat puis appelle la fusion du cœur. Sur Dolibarr 21 à 24, la fusion native supprime le répertoire documents du tiers absorbé avant de le déplacer ; le module copie d’abord les documents, réglage activé par défaut.
Et les contacts ?
Dolibarr n’a aucune fusion de contacts. Le module relie les tables connues (événements, catégories, contacts de documents, e-mailings, notifications…), dédoublonne les clés en conflit, propose un hook aux modules tiers et refuse la fusion si une table qu’il ne connaît pas référence le contact.
Puis-je l’utiliser sur une grosse base ?
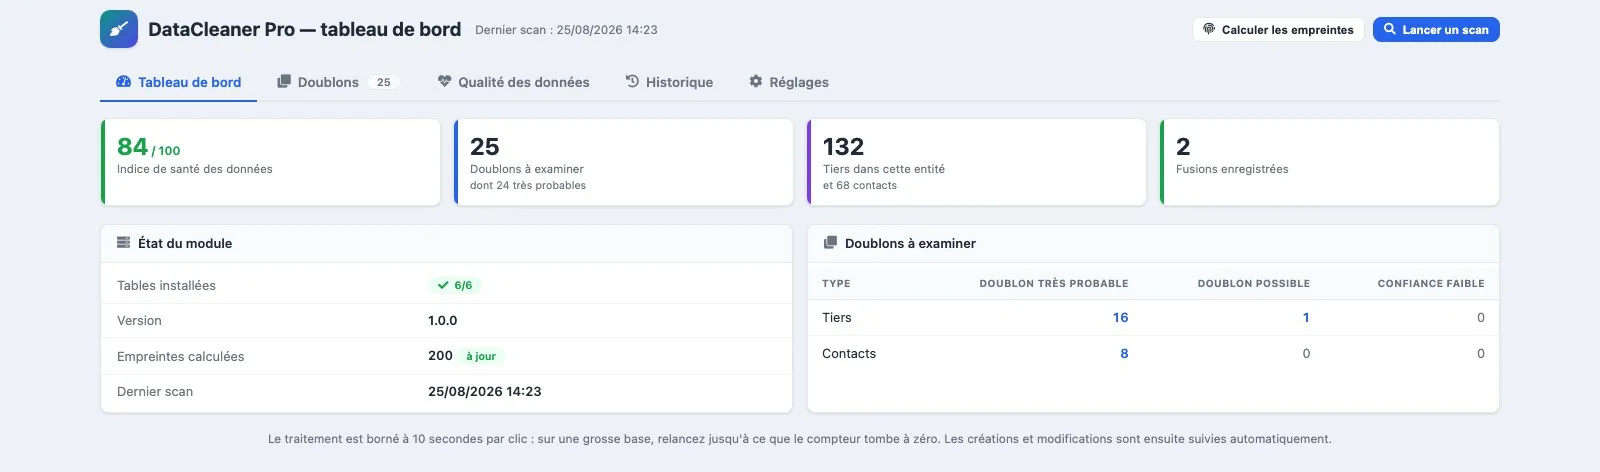
Les paires candidates sont construites en base par clés de regroupement, par lots, au lieu de comparer chaque fiche avec toutes les autres. L’essai documenté sur 20 000 tiers a calculé les empreintes en 15 s et scanné en 47 s avec 33 Mo de mémoire.
Qu’est-ce qui est stocké, et combien de temps ?
Les empreintes, les paires candidates, les scans et les instantanés d’audit des fusions, dans six tables du module. Les instantanés portent des données personnelles : une durée de conservation en jours est configurable et la tâche de purge supprime les plus anciens. Empreintes et paires disparaissent avec leur fiche source.
Le module peut-il empêcher la création de doublons ?
Quand un utilisateur crée un tiers ou un contact qui ressemble à une fiche existante, un avertissement propose d’ouvrir l’existant ou de créer quand même. Une option bloque la création quand le numéro de TVA est déjà utilisé.